現実世界で動くロボットのためのAI(Physical AI)を社会で使えるものにするうえで、画像と言葉からロボットの動作を生成するVLA(Vision-Language-Action)モデルを、強化学習で微調整する手法が注目されています。ただし、数値の上での「成功」が、ロボットの動作として本当に成功しているとは限りません。
本研究は、その手法の一つであるRL Tokenを独立に再実装するロボット学習実験から、成功の測り方そのものを見直す研究へと進みました。当初は改善に見えた数値が、実際には「皿の近くまで運んだ割合」だったと分かったためです。そこで人の動画確認、AIによる実装、画像を読むAIによる監査を組み合わせ、評価と報酬を作り直しました。
実験の舞台は、LeIsaacシミュレーター上のSO-101ロボットです。課題はオレンジ3個を皿へ運ぶこと。画像・言葉からロボットの動作を生成するモデルπ0.5を用い、RL Tokenという方式の独立再実装を試みました。
大きなモデル本体は固定し、その内部表現を256次元の小さな情報「RL token」に圧縮します。その情報を使い、動作を選ぶ部分と動作の良さを見積もる部分(actor-critic)だけを学習します。大きなモデル全体を更新せず、軽量な学習で動作を改善できるかを確かめる狙いでした。
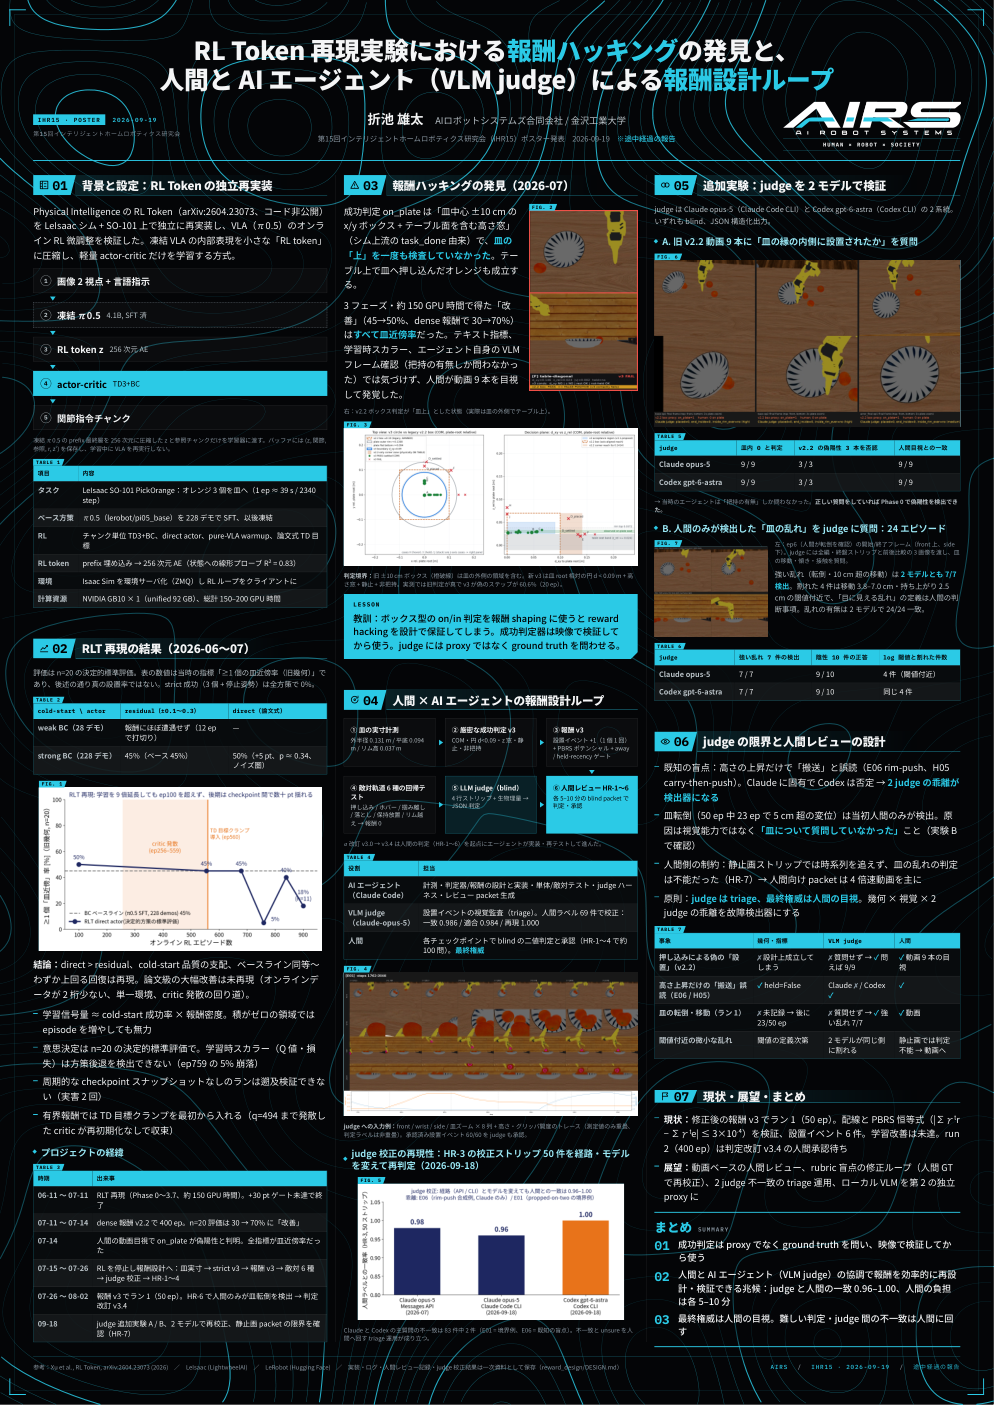
当初の評価では、ある条件で45%から50%、その後の細かな動作にも点を与える報酬の実験では30%から70%へ、指標が上昇しました。しかし、どちらも旧来の位置判定による「少なくとも1個が皿の近傍にある割合」であり、皿に正しく設置できた割合ではありません。3個の設置と停止姿勢を求める厳密なタスク成功は、全方策で0%でした。
人が動画9本を確認して、このずれが発覚しました。旧判定は皿の中心から前後左右に±10 cmの箱状領域と、テーブル面を含む高さの範囲を使っていました。皿の上にあるかを確かめていなかったため、テーブル上で皿のそばへ押し込んだオレンジにも成功を与えていたのです。
これは、狙った動作と異なる方法でも報酬を得られる「報酬ハッキング」の例です。学習結果だけでなく、学習を導く成功判定から見直す必要がありました。
そこで、成功判定から報酬までを作り直しました。まず皿の実寸を測って設置と呼べる領域を定め、皿を基準にした円形領域、高さ、静止、ロボットが掴んでいないことを組み合わせて、成功判定を厳密にしました。次に、正しく設置した時に1個につき1回だけ点を与える報酬v3を実装し、途中の動作を導く報酬にも条件を設けました。押し込み、皿の上での保持、掴み離し、落下、保持したまま放置、縁越えの6種の軌道を使い、偽の設置に点が入らないかもテストしています。最後に、画像を読むAIで設置イベントを監査し、人の判定・承認へつなぎます。人のレビューで問題が見つかるたびに、AIエージェントが判定や報酬を修正し、再テストする循環です。
実装を担うAIエージェントは、計測、成功判定と報酬の設計・実装、テスト、人に見せる確認資料の生成を担当しました。人は各段階で、判定ラベルを伏せた資料を見て判断し、次へ進めるかを承認しました。
画像と言葉を扱うAI(VLM judge)は、複数視点の画像や高さ・グリッパ開度などの測定値を使い、設置を視覚的に監査します。その役割は、疑わしい例や判断が割れた例を人へ回すための選別です。人の判定に合わせて校正した結果、VLM judgeの判定と人の判定の一致率は98.6%でした。それでも最終判断は人が担います。
当初のAIによる画像確認では「掴めているか」しか問わず、設置の失敗を見逃しました。旧動画9本に対して「皿の縁の内側に設置されたか」と質問し直すと、2つのモデルはともに9本すべてで皿内の設置を0と判定し、旧判定が誤って成功とした3本もすべて否認しました。人の目視と一致した結果です。
皿の転倒や移動も、当初は人だけが気づきました。その後、皿の移動・傾き・接触を明示的に質問すると、2つのモデルとも強い乱れ7件をすべて検出しました。確認できた成果の一つは、検査対象を質問に含めることで、既知の見逃しを検出できたことです。
ただし、閾値付近の小さな移動では、両モデルが同じ判断をしても測定値による判定と食い違いました。高さの上昇だけを搬送と読み違える例では、モデル間の不一致が手がかりになりました。AI同士の一致だけで正しさを保証することはできません。また、人も静止画の並びでは動きの順序を追えない例があり、人向けの確認資料は動画を中心とする方針にしました。
2026年9月19日の発表時点では、修正後の報酬v3で50エピソード(試行)を実行し、設置イベント6件を記録しました。報酬計算の接続と計算上の整合性を検証しましたが、学習による性能改善は未達です。次の400エピソードの実験は、成功判定v3.4への人の承認待ちでした。
この途中経過で示せたのは、旧指標の偽陽性を特定し、成功判定・報酬・監査の質問を具体的に修正して検証する手順です。今後は動画による人の確認と、AIの不一致や不確かな判断を人へ回す運用を続け、修正した報酬が実際の学習改善につながるかを確かめます。
人による映像確認と、VLM judgeのようなAIエージェントを組み合わせる進め方は、Human in the Loop(人が判断の輪に入る仕組み)と呼ばれます。数値の指標だけでは見えない失敗を見つけ、評価と報酬の設計を効率よく見直すこの進め方は、今後のPoC(概念実証)や実運用に向けた評価設計にも生かせると考えています。
2026年9月19日・20日に創価大学で開催された、日本ロボット学会 インテリジェントホームロボティクス(iHR)研究専門委員会の第15回研究会(iHR15)で、9月19日に折池雄太が発表した途中経過の報告です。この発表は、折池が受入研究員として所属する金沢工業大学 中沢研究室の記事でも紹介されています。関連する紹介記事(note)